La nube no es infalible: prepárate para más caídas en 2026
AWS estuvo caído 15 horas en 2025 y Forrester prevé dos caídas de varios días en 2026. Cómo diseñar tu empresa para el fallo sin salir de la nube.
Respuesta corta
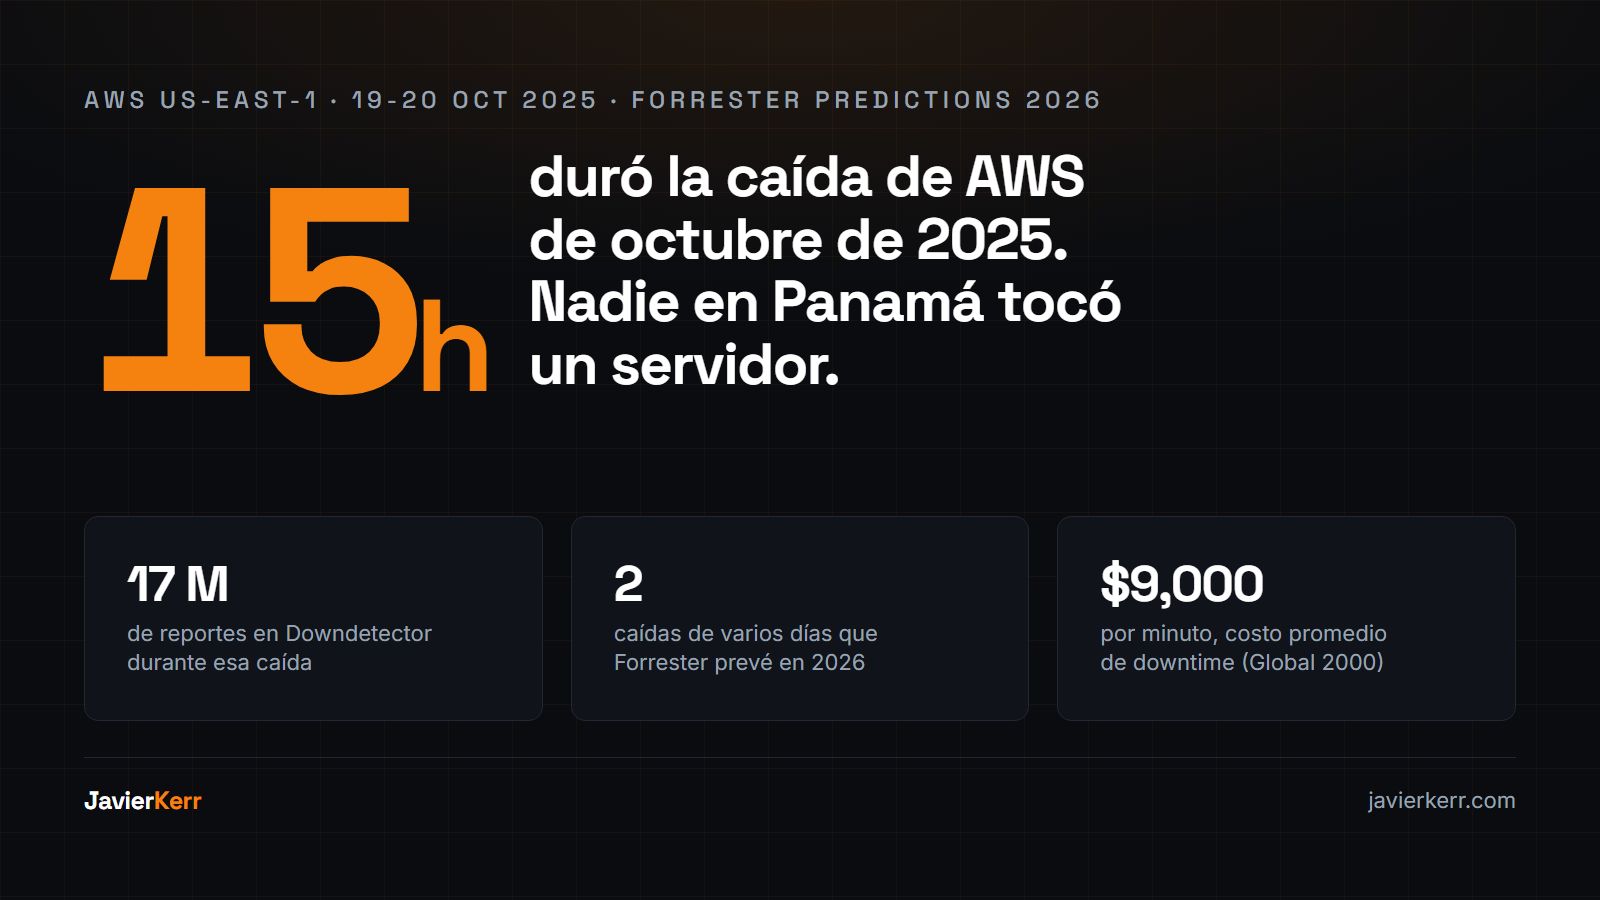
Estar en la nube no significa estar protegido contra interrupciones. En octubre de 2025 AWS estuvo degradado más de 15 horas y Forrester prevé al menos dos caídas de varios días en hyperscalers durante 2026. El riesgo no desaparece al migrar: cambia de lugar. La respuesta no es abandonar la nube sino diseñar para su fallo: respaldos independientes, monitoreo fuera del proveedor y recuperación probada.
Madrugada del lunes 20 de octubre de 2025. En Virginia, un registro DNS de DynamoDB queda vacío por una condición de carrera. En Panamá, nadie tocó un servidor. Y aun así, para el mediodía, hay empresas que no pueden facturar, apps que no cargan y un gerente preguntando por qué «lo que está en la nube» no responde.
Durante años, migrar a la nube se vendió como la forma de dejar de preocuparse por la disponibilidad. En muchos casos sigue siendo cierto. Pero hay una realidad que las organizaciones están empezando a enfrentar con más seriedad: estar en la nube no significa estar protegido contra las interrupciones.
¿Qué pasó con la nube en 2025?
Los grandes incidentes de 2025 dejaron una señal difícil de ignorar. AWS, Microsoft Azure, Google Cloud y Cloudflare tuvieron interrupciones que afectaron directa o indirectamente a miles de organizaciones. La más grande fue la de AWS en octubre.
TechTarget publicó en enero de 2026 un análisis con una conclusión incómoda: estos incidentes podrían dejar de ser eventos excepcionales y convertirse en un riesgo operativo que hay que incorporar a la estrategia de continuidad. No como escenario remoto. Como línea del plan.
¿Por qué una caída de AWS afecta a una empresa que no usa AWS?
Porque las dependencias no están donde crees. Una empresa mediana puede tener el ERP en un SaaS, la colaboración en Microsoft 365, la app de clientes en Azure, la autenticación en otro servicio y los respaldos en un tercero. Sobre el papel, todo está distribuido. En la práctica, detrás de esos cinco proveedores puede haber dos hyperscalers y una región.
Ese SaaS de facturación que usas probablemente corre en us-east-1. Su proveedor de correo transaccional también. La pasarela de pago, quizás. Ninguno te lo dijo, y no tenías por qué preguntarlo, hasta que los tres se cayeron a la misma hora.
La infraestructura puede estar distribuida físicamente. Las dependencias pueden seguir centralizadas. El riesgo no desaparece cuando migras a la nube: cambia de lugar.
¿Por qué Forrester espera más caídas en 2026?
Lee Sustar, analista principal de Forrester, lo escribió sin rodeos en las predicciones 2026 de la firma: «creemos que esta estrategia tendrá consecuencias en la forma de al menos dos caídas mayores de varios días en 2026».
La estrategia a la que se refiere es la de los hyperscalers: están invirtiendo cantidades enormes en centros de datos orientados a GPU para cargas de inteligencia artificial, mientras la infraestructura x86 y ARM heredada, que sostiene la mayoría de los servicios que tu empresa usa hoy, envejece y gana complejidad. Más carga, más piezas, menos atención sobre lo viejo.
Eso plantea una pregunta para cualquier responsable de tecnología: ¿estás diseñando tu operación para funcionar solo cuando todo lo demás funciona? Si la respuesta es sí, no tienes un problema de nube. Tienes un problema de resiliencia.
¿Cuánto cuesta de verdad una interrupción?
El informe «The Hidden Costs of Downtime» de Splunk, con encuesta de Oxford Economics, estima que las empresas Global 2000 pierden unos 400,000 millones de dólares al año por downtime. En promedio, 9,000 dólares por minuto, 540,000 por hora. Y la recuperación de ingresos tarda unos 75 días después del incidente.
Tu empresa no es Global 2000 y no pierde 9,000 dólares por minuto. Pero haz la cuenta con tu número: facturación anual entre las horas del año en que operas, por las horas que estuviste sin sistema. Para una pyme que factura 2 millones al año y opera 2,500 horas, una tarde de cinco horas sin facturar son 4,000 dólares de ingreso detenido, sin contar lo que se dejó de vender ni el cliente que no volvió. La proporción sobre el negocio suele ser peor que la de la empresa grande.
Y el impacto no termina cuando el servicio vuelve. La recuperación técnica no es la recuperación del negocio: quedan los pedidos que se perdieron, los acuerdos de servicio incumplidos, la reputación. Es el mismo patrón que separa tener backup de tener recuperación.
¿Entonces hay que salir de la nube?
No. Sería la conclusión equivocada. La nube sigue siendo una pieza central de cualquier infraestructura moderna y ofrece capacidades que serían caras y difíciles de replicar por tu cuenta.
El problema no es usar la nube. Es depender de ella sin diseñar para su fallo. La conversación tiene que pasar de «¿qué proveedor usamos?» a «¿qué pasa con el negocio si ese proveedor deja de estar disponible durante dos días?».
Esa segunda pregunta tiene respuestas de distinto tamaño, y no todas las empresas necesitan la más cara.
| Nivel | Qué es | Trampa habitual | Para quién |
|---|---|---|---|
| Respaldos independientes | Copia fuera del proveedor y de su identidad, inmutable, con restauración probada | Tener el backup «en la nube», en la misma cuenta y región que producción | Todas. Es el mínimo, y es barato |
| Monitoreo externo | Alertas y canal de comunicación que no dependen del proveedor que puede caer | Dashboards y avisos alojados en el mismo proveedor: se cae el servicio y se cae la visibilidad | Todas las que tengan un sistema crítico en línea |
| Multi-región | Servicios críticos distribuidos entre regiones del mismo proveedor | Dos regiones que dependen del mismo DNS, identidad o servicio global: un solo punto de fallo | Empresas con app propia y clientes que no pueden esperar |
| Multi-nube o híbrido | Más de un proveedor, o nube más infraestructura propia, con failover automatizado | «Tener cuentas en dos nubes» sin sincronización ni pruebas: pagas dos y no recuperas en ninguna | Operaciones donde dos días sin servicio equivalen a perder el negocio |
¿Cómo sabes que tu infraestructura está fallando?
Hay un elemento que casi siempre queda fuera de estas conversaciones. Si todo tu monitoreo, tus alertas, tus dashboards y hasta el chat del equipo dependen del mismo proveedor que está caído, no solo tienes una falla. Perdiste la visibilidad sobre la falla.
Una arquitectura resiliente contempla mecanismos de monitoreo y comunicación independientes para los servicios críticos. No hace falta que sean sofisticados: un chequeo externo desde otro proveedor y un canal de respaldo acordado (sí, puede ser un grupo de WhatsApp con reglas) resuelven el 80% del problema. Lo que importa es haberlo decidido antes.
Qué revisar esta semana
- Lista tus servicios críticos y pregúntale a cada proveedor dónde corre. Región y hyperscaler. Si tres de tus cinco sistemas viven en la misma región, ya sabes qué caída te deja fuera.
- Confirma que existe una copia fuera de ese proveedor y de su identidad. Y que alguien la restauró este trimestre. Si nunca se restauró, es una expectativa, no un respaldo.
- Mueve al menos un chequeo de monitoreo y un canal de aviso fuera del proveedor principal. Un monitor externo gratuito y un canal de respaldo acordado bastan para empezar.
- Escribe qué hace cada persona en las primeras dos horas sin el sistema principal. Quién atiende clientes, quién factura a mano, quién decide cuándo activar el plan B. Una página. Impresa.
Cuándo esto no te aplica
Si tu operación puede detenerse dos días sin perder clientes ni ingresos (hay negocios así, y no tiene nada de malo), el nivel de respaldos independientes es suficiente y lo demás es gasto. La resiliencia se compra en proporción a lo que cuesta no tenerla, no por moda.
Puntos clave
- La caída de AWS us-east-1 del 19-20 de octubre de 2025 duró unas 14.5 horas por un fallo de DNS en DynamoDB y generó más de 17 millones de reportes en Downdetector.
- Forrester prevé al menos dos caídas mayores de varios días en hyperscalers durante 2026, mientras la inversión se desvía hacia infraestructura de IA.
- Las empresas Global 2000 pierden 400,000 millones de dólares al año por downtime: 9,000 por minuto en promedio, y 75 días para recuperar ingresos (Splunk / Oxford Economics).
- El riesgo no desaparece al migrar a la nube: cambia de lugar. Las dependencias siguen concentradas aunque la infraestructura esté distribuida.
- El mínimo para cualquier pyme: respaldo fuera del proveedor y probado, monitoreo y canal de aviso independientes, y un procedimiento escrito para las primeras dos horas.
Si mañana a las 9 a.m. tu proveedor principal de nube deja de responder y no vuelve hasta el miércoles, ¿qué hace tu equipo a las 9:15?
Si la respuesta es «llamar a IT», ese es el hallazgo. La resiliencia no se compra; se diseña, y se ensaya antes de necesitarla.
Preguntas frecuentes
¿Cuánto duró la caída de AWS de octubre de 2025 y a quién afectó?
Según el informe post-incidente de AWS, la interrupción de us-east-1 (Virginia del Norte) empezó la noche del 19 de octubre de 2025 y duró unas 14.5 horas. La causó una condición de carrera en el DNS de DynamoDB, que arrastró a EC2, Lambda, ECS/EKS y otros. TechTarget contabilizó más de 17 millones de reportes en Downdetector, con Netflix, Snapchat y comercios electrónicos afectados.
¿Qué predice Forrester sobre caídas de la nube en 2026?
Lee Sustar, analista principal de Forrester, escribió en las predicciones 2026 de la firma que espera «al menos dos caídas mayores de varios días en 2026». La razón: AWS, Azure y Google Cloud están priorizando la inversión en centros de datos orientados a GPU para cargas de IA, mientras la infraestructura heredada que sostiene la mayoría de los servicios actuales envejece y gana complejidad.
¿Cuánto cuesta una hora de caída para una empresa?
El informe «The Hidden Costs of Downtime» de Splunk, con encuesta de Oxford Economics, estima que las empresas Global 2000 pierden unos 400,000 millones de dólares al año por downtime: cerca de 9,000 dólares por minuto o 540,000 por hora en promedio. Además, la recuperación de ingresos tarda unos 75 días después del incidente. Una pyme no pierde esas cifras, pero la proporción sobre su facturación suele ser peor.
¿Debo sacar mi empresa de la nube para evitar las caídas?
No. La nube sigue ofreciendo capacidades que serían caras y difíciles de replicar. El error no es usarla sino depender de ella sin diseñar para su fallo. Lo que cambia es la pregunta: de «qué proveedor usamos» a «qué pasa con el negocio si ese proveedor deja de responder». La respuesta define cuánta resiliencia comprar: multi-región, multi-nube, híbrido o simplemente respaldos y monitoreo independientes.
¿Qué es lo mínimo que una pyme debe tener para sobrevivir una caída de su proveedor de nube?
Tres cosas: una copia de respaldo fuera del proveedor y de su identidad (otra nube o un disco propio, inmutable y probada con restauración), un monitoreo y canal de aviso que no dependan del proveedor que puede caerse, y un procedimiento escrito de qué hace cada persona en las primeras dos horas sin el sistema principal. Sin eso, la caída del proveedor es también la pérdida de visibilidad sobre la caída.
Cómo trabajamos
Bibliografía
- TechTarget — Cloud outages expected to be the new normal in 2026 (Kathleen Casey, 14 de enero de 2026) — fuente principal: cifras de Downdetector, cita de Forrester y del informe de Splunk
- AWS — Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region — informe post-incidente oficial: fechas, causa raíz y servicios afectados
- Forrester — Predictions 2026: Cloud Outages, Private AI On Private Clouds, And The Rise Of The Neoclouds — predicción original de Lee Sustar
- Splunk — The Hidden Costs of Downtime (con Oxford Economics) — origen del costo de $400,000 millones anuales y $9,000 por minuto para empresas Global 2000
Sigue leyendo
- Continuidad & ResilienciaTienes backup. Eso no significa que tengas recuperación.El 76% de las organizaciones tardó más de 100 días en recuperarse de un ciberataque aun teniendo respaldos intactos. Backup y recuperación no son lo mismo — esta es la diferencia, y cómo medirla esta semana.
- Microsoft 365 & IdentidadMicrosoft 365 no respalda tu Microsoft 365Microsoft maneja la disponibilidad del servicio, no tus datos ni tu configuración de identidad. Qué cubre realmente el modelo de responsabilidad compartida en Microsoft 365 y Entra ID.
- Infraestructura & Ley 81¿El regreso de los servidores locales?Empresas medianas en Panamá mantienen su SaaS colaborativo en la nube pública, pero repatrían bases de datos, archivos confidenciales e IA interna a contenedores locales. La razón: costos predecibles y el cumplimiento de la Ley 81 de Protección de Datos Personales.